Исследование производительности систем обработки больших растровых геоданных: различия между версиями
Новая страница, с помощью формы Новый_командный_проект |
Нет описания правки |
||
| Строка 2: | Строка 2: | ||
|name=Исследование производительности систем обработки больших растровых геоданных | |name=Исследование производительности систем обработки больших растровых геоданных | ||
|company=НИУ ВШЭ | |company=НИУ ВШЭ | ||
|semester=Осень | |semester=Осень 2018 | ||
|course=3 | |course=3-4 | ||
|number_of_students=15 | |number_of_students=15 | ||
|categorize=yes | |categorize=yes | ||
}} | }} | ||
=== Что это за проект? === | |||
Геопространственные данные (геоданные) это такие данные, у которых есть географическая привязка. | |||
В современном мире, около 80% всех данных содержат географическую привязку: | |||
[https://www.forbes.com/sites/truebridge/2016/05/06/how-imaging-technologies-are-changing-the-world-part-2/ ссылка 1], | |||
[https://carto.com/blog/eighty-data-visualizations-examples-using-location-data-maps/ ссылка 2]. | |||
Растровые геоданные - | |||
временной ряд ('''1D'''), | |||
спутниковая сцена ('''2D'''), | |||
прогноз погоды/климата ('''3D'''), | |||
данные беспилотных летательных аппаратов (БПЛА), | |||
лидаров и другие N-мерные массивы, которые имеют географическую привязку. | |||
[[Файл:Wikience-wind-speed.png|200px|link=http://www.wikience.org/]] | |||
[[Файл:Wikience-mean-sea-level-pressure-and-isobars-300x300.png|200px|link=http://www.wikience.org/]] | |||
[[Файл:Wikience-co2-globe.png|200px|link=http://www.wikience.org/]] | |||
[[Файл:Wikience-no2.png|200px|link=http://www.wikience.org/]] | |||
При обработке этих данных мы встречаемся с такими основными проблемами: | |||
* большие данные: только лишь один DigitalGlobe, коммерческий провайдер спутниковых данных, собирает около [https://www.mapbox.com/blog/digitalglobe-maps-api/ 70 терабайт в день] | |||
* особый workload: растровые геоданные обрабатываются по-своему: нужны особые алгоритмы и подходы | |||
* облачные системы: для обработки больших данных нужно использовать компьютерные кластеры и распределенные системы | |||
Системы обработки больших растровых геоданных могут отвечать на такие вопросы: | |||
* '''Чрезвычайные ситуации''': какие районы города будут затоплены при повышении уровня воды на 1 метр (используются [https://en.wikipedia.org/wiki/Digital_elevation_model DEM])? | |||
* '''Сельское хозяйство''': как нужно удобрять поле, чтобы собрать больше урожая (точное земледелие, [https://en.wikipedia.org/wiki/Precision_agriculture precision agriculture])? | |||
* '''Городское планирование''': где и какие санитарно-гигиенические мероприятия нужно проводить, чтобы повысить качество воздуха? | |||
* и многие другие вопросы | |||
Конкретный пример: суперкомпьютер Blue Waters и спутниковые данные используются для предсказания урожая, что чрезвычайно важно для экономики: [https://aces.illinois.edu/news/illinois-research-accurately-predicts-us-end-season-corn-yield ссылка]. | |||
Исследование производительности систем обработки больших растровых геоданных заключается в следующем: | |||
* развернуть систему обработки данных в облаке либо на локальной машине | |||
* импортировать данные в систему | |||
* разработать запросы для системы с учетом ее особенностей (это поможет сделать ментор), чтобы выявить сильные и слабые стороны системы (с какими задачами система справляется лучше, а с какими хуже) | |||
* выполнить исследование системы: запустить запросы на системе с разным количеством узлов кластера, разным объемов данных, модифицировать запросы, чтобы улучшить или ухудшить производительность системы, найти данные на которых система работает лучше/хуже и т.п. | |||
'''Цель работы''' -- познакомиться с растровыми геоданными, изучить системы и особенности работы с ними. Это позволит существенно улучшить Ваше резюме. Например, многие системы основаны на Apache Spark, который является одной из самых популярных и востребованных работодателями систем работы с Большими Данными. | |||
Ментор этого проекта лично выступал на VLDB 2018 - одной из самых значимых в мире конференций по Большим Данным, Распределенным Системам, и Базам Данных: ChronosDB: Distributed, File Based, Geospatial Array DBMS [http://www.vldb.org/pvldb/vol11/p1247-zalipynis.pdf PDF]. Это единственный устный доклад от РФ за последние 10 лет. | |||
'''При командной работе задачи распределяются так''': студент берет себе одну из систем. | |||
Системы: | |||
* SciDB https://www.paradigm4.com | |||
* RasDaMan http://rasdaman.org/ | |||
* MrGeo https://github.com/ngageoint/mrgeo | |||
* GeoTrellis https://geotrellis.io/ | |||
* TileDB https://tiledb.io/ | |||
* PostgreSQL/PostGIS https://postgis.net/ | |||
* ClimateSpark https://github.com/feihugis/ClimateSpark | |||
* SciSpark https://scispark.jpl.nasa.gov/ | |||
* RasterFrames http://rasterframes.io/ | |||
* Python Dask https://dask.org/ | |||
* BigDAWG https://bigdawg.mit.edu/ | |||
* Язык программирования Julia https://julialang.org/ | |||
* Python/TensorFlow https://www.tensorflow.org | |||
* Myria http://myria.cs.washington.edu/ | |||
* ваши предложения | |||
=== | === Чему вы научитесь? === | ||
* работе с облачными сервисами Azure либо Amazon | |||
* работе с системами обработки растровых геоданных | |||
* основам новых языков программирования: некоторые (не все) системы используют Python/Scala/... для своего API, их знание не является обязательным для работы над проектом, они легко осваиваются по ходу работы | |||
* принципам работы алгоритмов обработки растровых геоданных | |||
=== Какие начальные требования? === | === Какие начальные требования? === | ||
* технический английский (для чтения статей) | |||
* язык программирования - любой, новый осваивается по ходу работы в зависимости от системы либо облачного сервиса | |||
* желание разбираться с геопространственными данными, системами и алгоритмами их обработки, облачными сервисами | |||
=== Какие будут использоваться технологии? === | |||
Перечень технологий доступен на сайте курса [http://rgeo.wikience.org/index2017.html Разработка геоприложений] | |||
=== Темы вводных занятий === | === Темы вводных занятий === | ||
Мы возьмем некоторые темы из курса [http://rgeo.wikience.org/index2017.html Разработка геоприложений] | |||
* что такое геопространственные данные, какие они бывают и какие особенности работы с ними | |||
* системы для обработки больших геопространственных данных | |||
* виды запросов и их особенности для обработки растровых геоданных | |||
=== Направления развития === | |||
* исследование производительности новейших систем, напр. Rheem http://da.qcri.org/rheem/ | |||
* исследование производительности машинного обучения с использованием геоданных | |||
* модификация систем для изменения поведения при ответе на запросы | |||
* комбинация в запросах не только растровых, но и векторных геоданных, данных других баз данных | |||
* использование данных из различных источников (NASA, ECMWF, ESA, ...) для исследования системы | |||
* публикация статьи в следующем году по результатам исследований: напр., Суперкомпьютерные дни в России http://www.russianscdays.org/, AIST https://aistconf.org | |||
=== Критерии оценки === | === Критерии оценки === | ||
4-5: | |||
* подготовить тестовые геоданные | |||
* реализовать импорт геоданных в выбранную систему | |||
* составить 10 одноэтапных (выполняющих какую-то одну пространственную операцию) запросов к системе | |||
* уметь с помощью API системы выполнять к ней запросы | |||
* построить диаграммы, графики и другие необходимые отчетные материлы иллюстрации производительности системы | |||
6-7: | |||
* все пункты '''4-5''', кроме запросов | |||
* уметь разворачивать систему на компьютерном кластере в облаке Azure/Amazon (если бесплатная версия системы это позволяет) | |||
* составить 10 (можно больше) сложных запросов к системе (запрос должен проверять сразу несколько аспектов работы системы) | |||
* уметь измерять время выполнения различных этапов работы системы (напр., подготовка данных, shuffling между узлами кластера, ...) | |||
8-10: | |||
* все пункты '''6-7''' | |||
* уметь создавать компьютерный кластер в облаке c помощью API Azure/Amazon (если это будет необходимо) | |||
* проверить работу системы на различных данных, их объемах и конфигурациях оборудования (кластера, если система распределенная) | |||
* подготовить UDF (User Defined Functions) для выполнения системой пользовательских запросов | |||
* научиться задавать расположение исходных данных на узлах кластера с помощью API системы | |||
* самостоятельно предлагать запросы, которые позволят выявить слабые и сильные стороны системы (на 10 баллов) | |||
Дополнительные баллы можно также получить при выполнении пунктов из раздела "Направления развития" | |||
=== | === Ориентировочное расписание занятий === | ||
По договоренности. Ориентировочно ВТ 16.40-18.10 (по четной неделе) | |||
Версия от 08:02, 20 октября 2018
| Компания | НИУ ВШЭ |
| Учебный семестр | Осень 2018 |
| Учебный курс | 3-4-й курс |
| Максимальное количество студентов, выбравших проект: 15 | |
Что это за проект?
Геопространственные данные (геоданные) это такие данные, у которых есть географическая привязка. В современном мире, около 80% всех данных содержат географическую привязку: ссылка 1, ссылка 2.
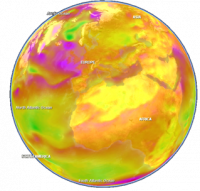
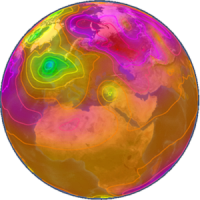
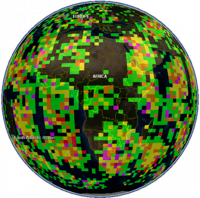
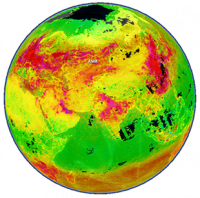
Растровые геоданные - временной ряд (1D), спутниковая сцена (2D), прогноз погоды/климата (3D), данные беспилотных летательных аппаратов (БПЛА), лидаров и другие N-мерные массивы, которые имеют географическую привязку.
При обработке этих данных мы встречаемся с такими основными проблемами:
- большие данные: только лишь один DigitalGlobe, коммерческий провайдер спутниковых данных, собирает около 70 терабайт в день
- особый workload: растровые геоданные обрабатываются по-своему: нужны особые алгоритмы и подходы
- облачные системы: для обработки больших данных нужно использовать компьютерные кластеры и распределенные системы
Системы обработки больших растровых геоданных могут отвечать на такие вопросы:
- Чрезвычайные ситуации: какие районы города будут затоплены при повышении уровня воды на 1 метр (используются DEM)?
- Сельское хозяйство: как нужно удобрять поле, чтобы собрать больше урожая (точное земледелие, precision agriculture)?
- Городское планирование: где и какие санитарно-гигиенические мероприятия нужно проводить, чтобы повысить качество воздуха?
- и многие другие вопросы
Конкретный пример: суперкомпьютер Blue Waters и спутниковые данные используются для предсказания урожая, что чрезвычайно важно для экономики: ссылка.
Исследование производительности систем обработки больших растровых геоданных заключается в следующем:
- развернуть систему обработки данных в облаке либо на локальной машине
- импортировать данные в систему
- разработать запросы для системы с учетом ее особенностей (это поможет сделать ментор), чтобы выявить сильные и слабые стороны системы (с какими задачами система справляется лучше, а с какими хуже)
- выполнить исследование системы: запустить запросы на системе с разным количеством узлов кластера, разным объемов данных, модифицировать запросы, чтобы улучшить или ухудшить производительность системы, найти данные на которых система работает лучше/хуже и т.п.
Цель работы -- познакомиться с растровыми геоданными, изучить системы и особенности работы с ними. Это позволит существенно улучшить Ваше резюме. Например, многие системы основаны на Apache Spark, который является одной из самых популярных и востребованных работодателями систем работы с Большими Данными.
Ментор этого проекта лично выступал на VLDB 2018 - одной из самых значимых в мире конференций по Большим Данным, Распределенным Системам, и Базам Данных: ChronosDB: Distributed, File Based, Geospatial Array DBMS PDF. Это единственный устный доклад от РФ за последние 10 лет.
При командной работе задачи распределяются так: студент берет себе одну из систем.
Системы:
- SciDB https://www.paradigm4.com
- RasDaMan http://rasdaman.org/
- MrGeo https://github.com/ngageoint/mrgeo
- GeoTrellis https://geotrellis.io/
- TileDB https://tiledb.io/
- PostgreSQL/PostGIS https://postgis.net/
- ClimateSpark https://github.com/feihugis/ClimateSpark
- SciSpark https://scispark.jpl.nasa.gov/
- RasterFrames http://rasterframes.io/
- Python Dask https://dask.org/
- BigDAWG https://bigdawg.mit.edu/
- Язык программирования Julia https://julialang.org/
- Python/TensorFlow https://www.tensorflow.org
- Myria http://myria.cs.washington.edu/
- ваши предложения
Чему вы научитесь?
- работе с облачными сервисами Azure либо Amazon
- работе с системами обработки растровых геоданных
- основам новых языков программирования: некоторые (не все) системы используют Python/Scala/... для своего API, их знание не является обязательным для работы над проектом, они легко осваиваются по ходу работы
- принципам работы алгоритмов обработки растровых геоданных
Какие начальные требования?
- технический английский (для чтения статей)
- язык программирования - любой, новый осваивается по ходу работы в зависимости от системы либо облачного сервиса
- желание разбираться с геопространственными данными, системами и алгоритмами их обработки, облачными сервисами
Какие будут использоваться технологии?
Перечень технологий доступен на сайте курса Разработка геоприложений
Темы вводных занятий
Мы возьмем некоторые темы из курса Разработка геоприложений
- что такое геопространственные данные, какие они бывают и какие особенности работы с ними
- системы для обработки больших геопространственных данных
- виды запросов и их особенности для обработки растровых геоданных
Направления развития
- исследование производительности новейших систем, напр. Rheem http://da.qcri.org/rheem/
- исследование производительности машинного обучения с использованием геоданных
- модификация систем для изменения поведения при ответе на запросы
- комбинация в запросах не только растровых, но и векторных геоданных, данных других баз данных
- использование данных из различных источников (NASA, ECMWF, ESA, ...) для исследования системы
- публикация статьи в следующем году по результатам исследований: напр., Суперкомпьютерные дни в России http://www.russianscdays.org/, AIST https://aistconf.org
Критерии оценки
4-5:
- подготовить тестовые геоданные
- реализовать импорт геоданных в выбранную систему
- составить 10 одноэтапных (выполняющих какую-то одну пространственную операцию) запросов к системе
- уметь с помощью API системы выполнять к ней запросы
- построить диаграммы, графики и другие необходимые отчетные материлы иллюстрации производительности системы
6-7:
- все пункты 4-5, кроме запросов
- уметь разворачивать систему на компьютерном кластере в облаке Azure/Amazon (если бесплатная версия системы это позволяет)
- составить 10 (можно больше) сложных запросов к системе (запрос должен проверять сразу несколько аспектов работы системы)
- уметь измерять время выполнения различных этапов работы системы (напр., подготовка данных, shuffling между узлами кластера, ...)
8-10:
- все пункты 6-7
- уметь создавать компьютерный кластер в облаке c помощью API Azure/Amazon (если это будет необходимо)
- проверить работу системы на различных данных, их объемах и конфигурациях оборудования (кластера, если система распределенная)
- подготовить UDF (User Defined Functions) для выполнения системой пользовательских запросов
- научиться задавать расположение исходных данных на узлах кластера с помощью API системы
- самостоятельно предлагать запросы, которые позволят выявить слабые и сильные стороны системы (на 10 баллов)
Дополнительные баллы можно также получить при выполнении пунктов из раздела "Направления развития"
Ориентировочное расписание занятий
По договоренности. Ориентировочно ВТ 16.40-18.10 (по четной неделе)